11月17日机锋网消息,11 月 16 日英特尔公布代号 Crescent Island 的 D270 数据中心 GPU 性能数据。官方测试显示,这款 350W 风冷加速卡在特定金融计算场景吞吐量最高可达 600W 英伟达 RTX PRO 6000 Blackwell 服务器版的 5.9 倍,面向 HPC 仿真与 AI 智能体融合工作流打造。
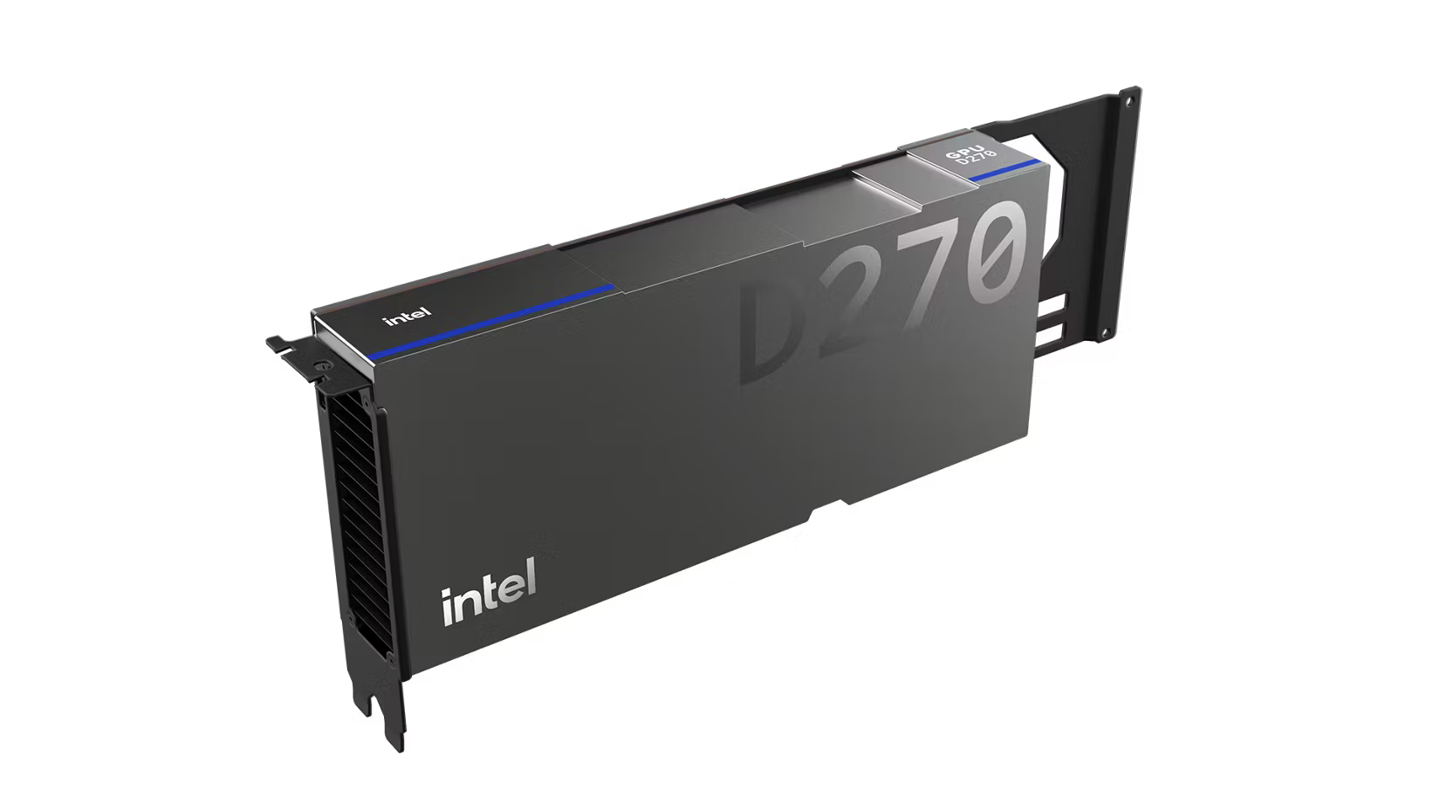
D270 基于 Xe 3P 架构,配备 32 个 Xe 核心、256 个 XMX 矩阵引擎,支持灵活算力精度:推理场景使用 FP4-FP8 低精度提升吞吐,科研、工程、金融仿真可启用全速原生 FP64,保障数值计算精度。标配 160GB LPDDR5X 内存、1.5TB/s 带宽,合作伙伴版本最高可扩至 480GB,大容量显存可常驻仿真数据集,减少数据迁移损耗。板卡为标准 PCIe 风冷形态,适配现有企业服务器机架。
当下 HPC 正从传统数值模拟转向仿真、分析、AI 推理一体化流程,AI 智能体嵌入仿真循环,自主筛选参数、监控仿真状态、调整计算策略。英特尔联合 SambaNova 推出异构解耦方案:D270 负责高负载预填充任务,SambaNova SN50 RDU 承担解码阶段,至强 6/6 + 处理器统筹调度,整套方案在现有风冷机架功耗限制内运行,无需新建算力设施。该方案将在芝加哥 SC26 超算展现场演示。
其余测试数据显示,预生产 D270 运行 Drex 2.0 决策模型,延迟较竞品最高降低 29%;跑 Qwen 3 30B – A3B³ 模型时吞吐量为同级竞品 1.12 倍。
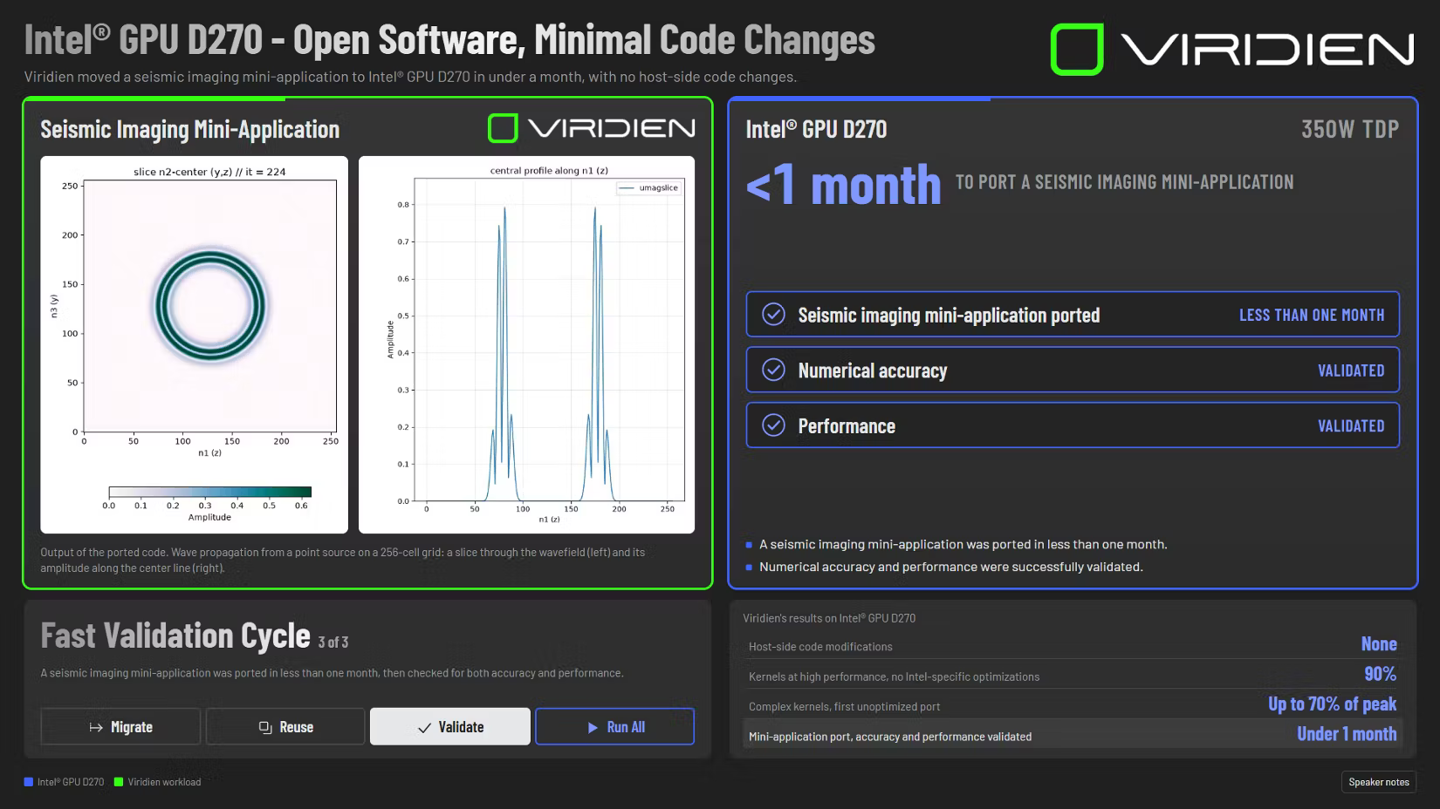
软件层面依托开放 SYCL、Intel MPI 与高性能编译器,兼顾传统 HPC 代码与 AI 框架,无厂商锁定。地震成像项目案例印证,原有 CUDA/HIP 程序移植成本低,多数内核无需深度调优即可发挥性能,可在短时间完成迁移验证。
业界常将 D270 归类为推理 GPU,而英特尔本次着重强调其 FP64 算力、大显存与开放生态带来的 HPC 适配能力,定位为异构融合加速器,面向超算中心与科研机构,降低 AI 智能体 + 数值仿真流水线的落地门槛。