做后台开发的程序员,最近被一个词刷屏:决策模型。
事情要从 TypeSafe 的 Jev 说起,一个不生成文字、只做判断的模型。9 月 15 日,它一上线就火得离谱,36 小时涌进 14 万开发者申请内测,Vercel、Cloudflare、LangChain 连夜接入。
紧接着,OpenAI 在 2026 DevDay 推出了自己的同类产品:Decisions API。
本文将围绕四个问题讲透 Decisions API,即它是什么,它和 Jev 是什么关系,怎么使用和你的项目该优先选谁。
Decisions API:给 “下判断” 单独开一条赛道
先想个场景。你开网店,客户发来一条消息:“键盘到了,但是三个按键是坏的,能换吗?”程序得先决定一件事:这条工单进哪个队列?退货、账单、物流,还是人工?
常规做法是丢给大模型,让它返回一段 JSON。这种做法可行,但存在两个痛点:速度慢,成本高。原因是为了一次判断要生成一整个回答,数千个请求堆下来,延迟和成本都扛不住。
OpenAI 的 Decisions API 就是为这种 “只要一个决定、不需要长篇输出” 的场景开的专用接口。
它不让你写 prompt 让模型自由发挥,而是让你把问题预先定义好、把答案限制在有限集合里,模型只从里面挑一个,返回结构化结果和置信度。
官方口径是 Decisions API 基于 GPT-6 Luna 构建,大约 150 毫秒返回判断结果,速度比同一模型走 Responses API 快约 10 倍。
说明:这个 “快 10 倍” 是拿自家 Responses API 当参照系,不是跟 Jev 的横向时间对比。
Decisions API 提供三种问题类型,全部结构化返回:
类型 | 作用 | 返回 |
谓词 | 判断某陈述是否成立 | 0-1 的概率 |
选择 | 从预设选项里选一个 | 选中项+概率+置信度 |
配乐 | 按离散档位打分 | 分数+各档概率+置信度 |
几个容易踩的细节:
• 谓词返回的是概率不是布尔值,在哪个阈值上 “算成立” 由你的业务代码决定,OpenAI 不给标准答案。
• Decisions API 会拒绝部分问题,即返回 refal,可能是因为内容安全等原因。读结果前先判断 answer.type,别直接当成 choice 或 predicate 用。
• 设计答案选项本身就是应用设计的一部分。比如客户问 “营业时间”,你只给 “账单” 和 “物流” 两个选项就不合理,最好加一个通用兜底类别。拿真实客户消息去测你的类别,包括那些归不进任何类别的问题。
定价也单独算:输入 $0.10/百万 token,输出、缓存读取、缓存写入都不收费(长上下文倍率和区域附加费另算)。估算输入量时,问题本身和它的描述也占 Token,别漏算。
一句话适用边界:凡是 “答案是有限集合里的一个” 的高频判断,包括消息路由、选搜索索引、给 Agent 选下一步动作、内容策略选型都适合。
反过来,凡是需要写说明文字、或要从任意文本里抽取字段拼成 JSON 的场景,别硬塞给 Decisions API,那是 Responses API 结构化输出的活。
Decisions API 和 Jev 的关系:同一个赛道,两种打法
要说清关系,得先把 Jev 讲明白。
Jev 是 TypeSafe AI 发布的第一款 “System One” 模型,名字借了卡尼曼 “系统一” 的概念,指快速、直觉式的判断;而 ChatGPT 这类大模型属于 “系统二”。
创始人之一 Diogo Almeida 是前 OpenAI 研究员,参与过 ChatGPT 研发和 RLHF。
他的核心判断是:大语言模型是给 “人话” 优化的,但计算机要的是类型确定、能直接执行的结果;而 RLHF 调出来的概率不可靠。
所以,Jev 干脆不做文本生成,只输出带概率的判断,训练目标用面向校准决策的强化学习(RLCD),即让模型说有 0.9 把握时,真实命中率确实接近 90%。
Jev 有和 Decisions API 对应的三种原语:Noul(输出 0/1 概率,约等于 predicate)、Choice、配乐。它更便宜,输入 $0.042/M,输出免费,延迟 70500ms,但只吃文本(包括结构化文本状态),读不了图。
关系其实很直接:两者做的是同一件事,接收输入,在 “预设问题+有限答案” 里返回结构化判断和置信度,不生成自然语言。
Jev 是这条赛道的引爆者,Decisions API 是 OpenAI 带着生态和图像能力下场打的对标产品,连原语都能一一对应:
Jev | Decisions API | 解决的问题 |
noul | predicate | 是/否二分类 |
choice | choice | 多选概率 |
score | score | 档位评分 |
现在两者都还不是 “通用判断”,而是绑定各自模型的专用接口:OpenAI 用 gpt-6-luna,TypeSafe 用 jev-1.13.0。
Decisions API 应用示例详解
理论讲完,接着讲实操。三个例子都能独立跑通,用 Python 写代码。
准备环境
• 安装 openai 3.26.0 或更高:pip install openai==3.26.0
• 一个 OpenAI API key,设置环境变量 OPENAI_API_KEY
• 三个文件分别存为 decisions_route.py/decisions_document.py/decisions_image.py
SDK 里对应的方法是 client.decisions.create(),请求打到 /v1/decisions。推理在 OpenAI 服务端跑,客户端只负责发请求。
示例 1:客服工单路由(choice)
应用场景:网店四条队列是退货、账单、物流,外加一条通用兜底。
from openai import OpenAI


MODEL = "gpt-6-luna"


def main() -> None:
    with OpenAI(timeout=20.0) as client:
        result = client.decisions.create(
            model=MODEL,
            input="My keyboard arrived with three broken keys. Can you replace it?",
            questinotallow=[{
                "type": "choice",
                "name": "queue",
                "instructions": "Choose the queue for the customer's main request.",
                "choices": [
                    {"value": "returns", "description": "Damaged goods or replacements."},
                    {"value": "billing", "description": "Charges or invoice errors."},
                    {"value": "delivery", "description": "Missing or delayed deliveries."},
                    {"value": "general", "description": "Everything else or unclear intent."},
                ],
            }],
        )
        answer = result.answers[0]
        if answer.type == "refusal":
            print("Send to manual triage")
        elif answer.type == "choice":
            print(answer.choice, answer.confidence)
            queue = answer.choice if answer.confidence >= 0.8 else "manual_triage"
            print("Queue:", queue)


if __name__ == "__main__":
    main()
运行结果:
returns 1.0
Queue: returns
换一句 “你们有网站可以看吗?”,输出:
general 0.8
Queue: general
两个判断都对。注意两点:
- choice 对象包含 value 和 description,description 帮你区分 “损坏的商品” 和 “从没送到“ 这类近义场景;
- 0.8 这个置信度阈值只是示例,不是 OpenAI 的建议值,也不代表 80% 准确率。
正确做法是先拿一批人工标注过的消息,测试不同阈值下的错误率,再定最终阈值。
示例 2:检查文档缺失信息(谓词)
应用场景:员工退货说明格式不一,想自动标记那些缺失截止日期或邮寄地址的订单。
from openai import OpenAI, RateLimitError


MODEL = "gpt-6-luna"


def main() -> None:
    with OpenAI(timeout=20.0) as client:
        checks = {
            "deadline": "Does the text explicitly give a deadline for returning an item?",
            "address": "Does the text explicitly provide a postal return address?",
        }
        result = client.decisions.create(
            model=MODEL,
            input="Return the item within 30 days. Email support to request our address.",
            questinotallow=[
                {"type": "predicate", "name": name, "instructions": question}
                for name, question in checks.items()
            ],
        )
        for answer in result.answers:
            if answer.type == "refusal":
                print(answer.name, "review required")
            elif answer.type == "predicate":
                status = "present" if answer.probability >= 0.9 else "check manually"
                print(answer.name, status, answer.probability)


if __name__ == "__main__":
    try:
        main()
    except RateLimitError as exc:
        if exc.code == "credit_balance_exhausted":
            raise SystemExit(
                "Your OpenAI API credit balance is exhausted. Add credits for "
                "the organisation associated with your API key at "
                "https://platform.openai.com/settings/organization/billing/ "
                "and then run this example again."
            ) from None
        raise
输出:
deadline present 1.0
address check manually 0.0
“30 天内退货” 有明确截止日期,概率为 1.0;但 “Email support to request our address” 只是让你去索取地址,并没有真的给出地址,所以 address 是 0.0。这正是措辞的重要性。如果只搜索关键词 address,就漏了这层区别。
这里两个问题彼此不依赖,所以可以塞进同一次请求;如果后面的问题要用前面问题的结果,就得等拿到结果后再发新请求。
另外提醒:这一步只检查 “文本里有没有”,判断这个地址是否真实存在、这个截止日期是否符合业务规则,是另外的验证环节。
示例 3:检查产品照片(predicate+图片)
这是 Decisions API 相对 Jev 的杀手锏:能看图。
应用场景:三张包裹照片,一张严重损坏、一张轻微损坏、一张完好无损,让模型判断有没有可见损伤。
三张示例包裹图(与脚本同目录,分别为 heavy_damage.png、slight_damage.png、undamaged.png):
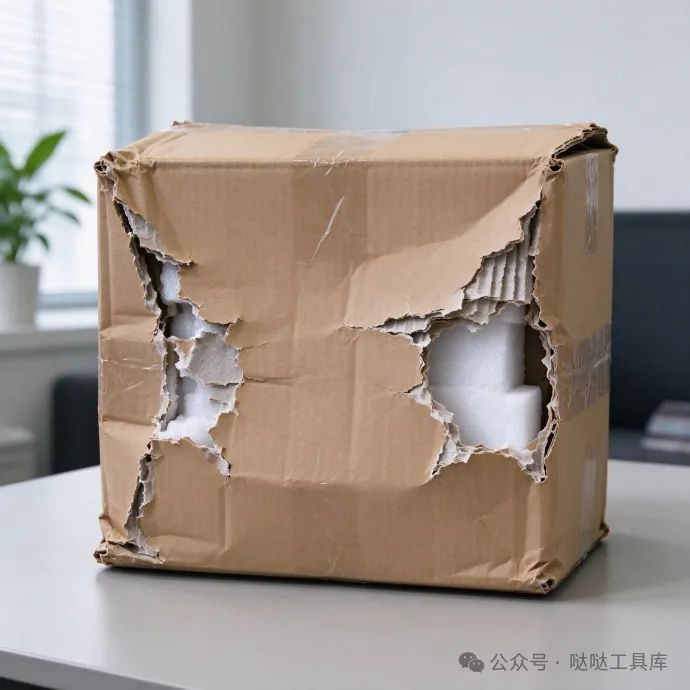
严重损坏的包裹 | heavy_damage.png
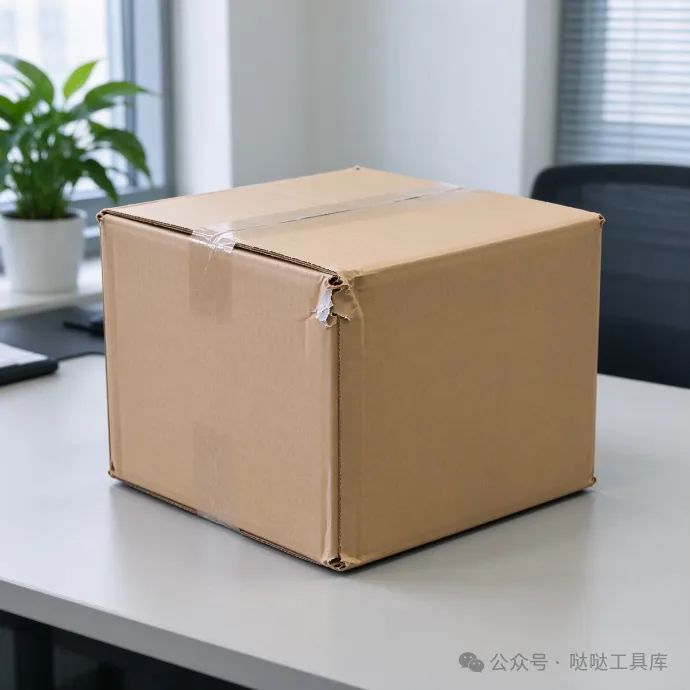
轻微损坏的包裹 | slight_damage.png
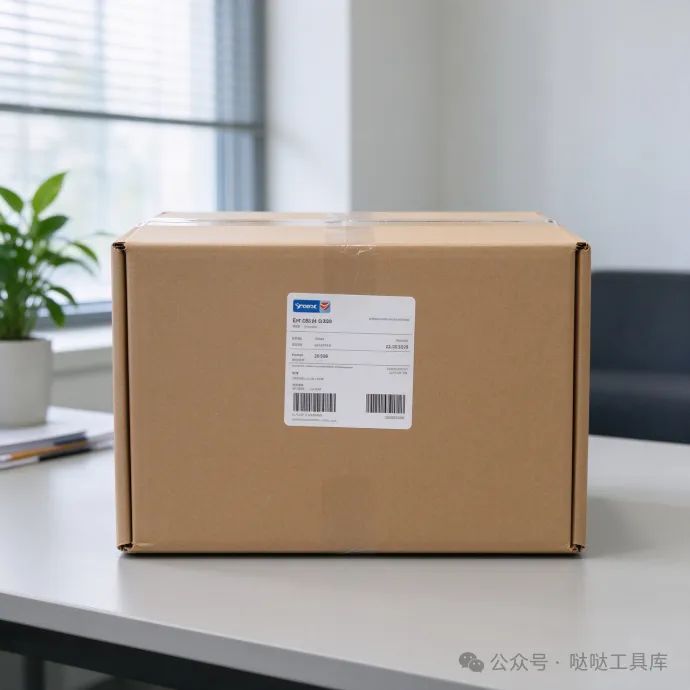
完好无损的包裹 | undamaged.png
import base64
from pathlib import Path
from openai import OpenAI, RateLimitError


MODEL = "gpt-6-luna"
PARCEL_IMAGES = ("undamaged.png", "heavy_damage.png", "slight_damage.png")


def main() -> None:
    with OpenAI(timeout=20.0) as client:
        for filename in PARCEL_IMAGES:
            image_path = Path(__file__).with_name(filename)
            encoded = base64.b64encode(
                image_path.read_bytes()
            ).decode("ascii")
            result = client.decisions.create(
                model=MODEL,
                input=[{
                    "role": "user",
                    "content": [
                        {
                            "type": "input_text",
                            "text": "Image of a delivered parcel.",
                        },
                        {
                            "type": "input_image",
                            "image_url": f"data:image/png;base64,{encoded}",
                        },
                    ],
                }],
                questinotallow=[{
                    "type": "predicate",
                    "name": "visible_damage",
                    "instructions": (
                        "Does the packaging visibly have a tear, "
                        "hole or crushed corner?"
                    ),
                }],
            )
            answer = result.answers[0]
            if answer.type == "refusal":
                print(f"{filename}: Inspect the photograph manually")
            elif answer.type == "predicate":
                print(
                    f"{filename}: Probability of visible packaging "
                    f"damage: {answer.probability}"
                )


if __name__ == "__main__":
    try:
        main()
    except RateLimitError as exc:
        if exc.code == "credit_balance_exhausted":
            raise SystemExit(
                "Your OpenAI API credit balance is exhausted. Add credits for "
                "the organisation associated with your API key at "
                "https://platform.openai.com/settings/organization/billing/ "
                "and then run this example again."
            ) from None
        raise
输出:
undamaged.png: Probability of visible packaging damage: 0.05
heavy_damage.png: Probability of visible packaging damage: 1.0
slight_damage.png: Probability of visible packaging damage: 0.98
完好的包裹 0.05,严重损坏 1.0,都在意料之中。轻微损坏那张 0.98 有点意外。但也说得通,哪怕只是轻微破损,肉眼也能看出来,模型给高分不奇怪。这正好说明 Decisions API 在多模态质检上的价值。
几个硬性限制要记住:
- 图片必须用 base64 内联的 data URL,普通网页 URL 和文件 ID 都不接受;
- 单请求最多 128 张图;
- 消息输入只支持 user 角色,且只含文本+图片。
Decisions API 与 Jev 的比较和选择
先上一张对比表(截至 2026 年 10 月初):
维度 | OpenAI决策 | Jev 1.13 |
模型 | GPT-6-月球 | JEV-1.13.0 |
输入 | 文本+图片 | 文本/结构化文本状态 |
问题组织 | 有序数组 | 按名字的 Map |
是/否 | 谓词→概率 | noul → 概率 |
多选 | 选择→ 选中项、概率、置信度 | 选择→ 选中项、概率、置信度 |
评分 | score →分数、概率、置信度 | score →分数、概率、置信度、legend |
价格(/百万输入) | 0.10美元 | 0.042美元 |
输出计费 | 免费 | 免费 |
上下文限制 | 基于 Luna,上下文很大 | 完整请求最多 64K token |
补充说明:Decisions API 单请求最多可批量放 200 个问题;Jev 的 64K 是完整请求的上限,其中 “状态+最长问题“ 要控制在 32K 以内。两家计费口径不同,最终成本以实际请求大小为准。
关键差异,按决策优先级排序:
1. 图片:Decisions 支持、Jev 目前不支持。涉及商品质检、视觉内容审核,只能选 Decisions API。
2. 价格:Jev 输入 $0.042/M,比 OpenAI 的 $0.10/M 便宜约 58%。量大时差价非常明显。
3. 拒答机制:Decisions 会拒绝部分问题,Jev 永远在选项内给答案。OpenAI 的设计是为了在识图等敏感场景兜底,但拒答时业务方得自己处理。
4. 速度:Decisions 平均略快(约 150ms vs Jev 的 70~500ms),但毫秒级差距在绝大多数业务场景里体感不明显,不值得为它多付两倍多的钱。
5. 准确率:在常见分类、工单分流任务上基本持平,没有明显差距。
选型建议:
• 纯文本、量大、预算敏感 → 选 Jev,成本优势明显。
• 需要处理图片 → 只能选 Decisions API,Jev 读不了图。
• 对延迟有极致要求 → 两者差距很小,别为速度溢价买单。
• 怕敏感图出岔子 → Decisions 的拒答机制能兜一层;想永远有答案 → 选 Jev。
另外提醒一句:这个赛道竞争很激烈,别只看这两家。
微软 10 月初发布了 Microsoft-Decision-1,定价和 Jev 相同($0.042/M),中位延迟 85ms 比两家都快;Jev 火起来后开源复现(如 Nimble)也出来了,国内 StartLux 的 StartLux-Decision 在公开评测里宣称超过 Jev。
选型时,大家可以多留意这些新选项。
结论:Decisions API 是 Jev 的终结者吗?
回到开头的问题:至少现在还不是。
以我实测的经验,Jev 的优势是极致低价+快速响应,Decisions API 的优势是能读图+背靠 OpenAI 生态。
它们不是谁取代谁,而是把 “快判断” 这件事,从大模型的高成本泛化输出里独立出来,变成一个专门品类。
值得带走的一套判断框架:
• 把算术和固定业务规则留在普通代码里,模型不掺和。
• 把 “输入难以被规则轻易识别” 的模糊判断交给决策模型。其中,客户用几种不同说法描述同一故障,就是典型的模型场景。
• 需要书面说明、需要抽取任意字段拼 JSON 时,才动用生成式大模型。
选哪家,先看你有没有图片需求,再看对价格敏不敏感,最后才轮到毫秒级的速度差异。