我是韩先超,51CTO 学堂 K8s、Python 教学总监、AIOps 实战训练营讲师,云计算架构师,具有 8 年项目实战经验+5 年教学经验,线上学员已达 300w+。
关键词:AIOps、DeepSeek、Prometheus、Zabbix、MCP、RAG、预测扩容
技术栈:DeepSeek+Prometheus/Zabbix/EFK+Jenkins+Kubernetes
适用对象:已经有监控平台,想把大模型接到日常值班里的运维团队
业务上了 Kubernetes 之后,告警越来越多,故障却越来越难查。固定阈值经常白天漏报、夜里误报;半夜出问题还得开机连 VPN。虽然大模型能看日志、写方案,但直接让它改生产,谁都不敢。
我在互联网、政企和研究院做过一批项目,核心做法很简单:原来的 Prometheus、Zabbix、EFK 继续用,大模型只负责分析和给建议,真正改集群、改流水线之前,先模拟执行,再让人点确认。
下面用 10 个能跑起来的小项目说明运维怎么做,并附上关键代码和界面截图。
现在运维到底卡在哪
云原生普及以后,一个故障很少只打一条告警。订单接口变慢,往往会同时冒出 API 延迟、Pod 起不来、缓存命中率下降、支付超时。
值班的人面对几十上百条告警,分不清哪条是根因、哪条是连带出来的。真正严重的问题,反而容易被淹没。
还有几个很常见的麻烦:
- 查故障要在监控、日志、集群事件之间来回翻,耗时长。
- 夜里出问题必须坐到电脑前、连上 VPN,才能点 Jenkins、改 K8s。
- 公司里其实有不少故障手册和历史工单,但通用大模型不知道这些,给出来的命令经常和环境对不上。
- Kubernetes自带的 HPA 只看当前 CPU,流量突然上来时,新 Pod 还要冷启动几十秒到两分钟,业务已经开始 503 了。
行业里的数字也差不多是这个意思。中国信通院 2024 年调查里,一半以上企业觉得自己到了比较深的智能化阶段,但大模型大多还停在研究了解阶段,真正接到生产里的不多。
PagerDuty 早期做过 AIOps 的用户,告警噪声平均能降大约 87%。说明事能做成,难的是怎么安全地做成。
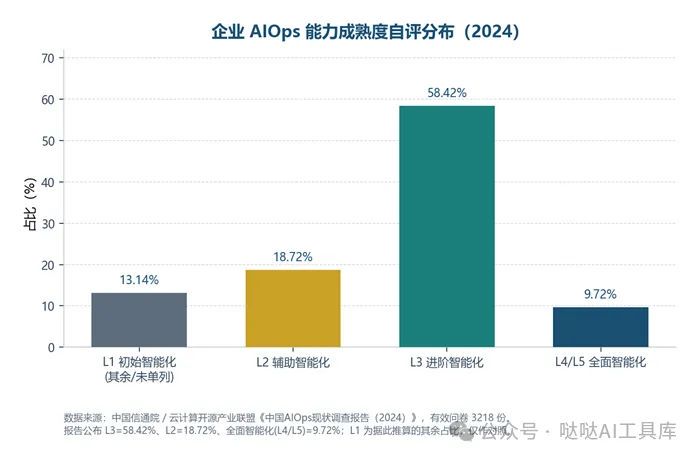
图 1:企业 AIOps 能力自评分布(数据来源:中国信通院 2024 年调查)
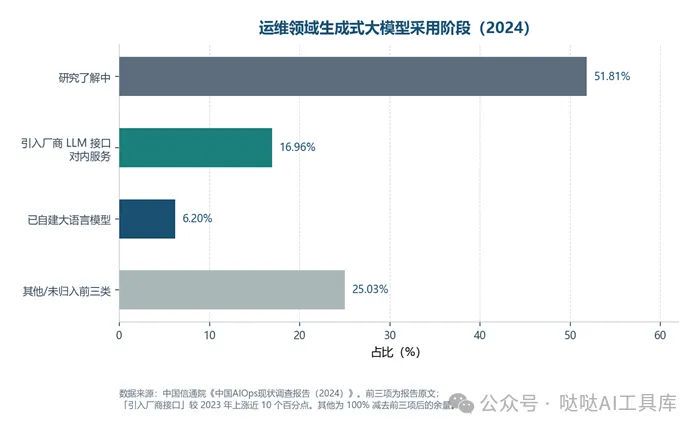
图 2:运维领域用大模型的阶段:大多数还在了解,真正自建的很少
我做这些项目时,遵守这三条规则:
1. 不推倒现有监控。Zabbix、Prometheus、EFK继续采集,大模型接在后面做分析。
2. 大模型负责 “看” 和 “想”,拉数据、调接口、改集群交给程序去做,不要让模型自己拼命令满地跑。
3. 自动修复默认先模拟跑一遍(dry-run)。核心进程不能乱动,改生产必须人点头。
可以这么记:监控负责 “看”,大模型负责 “想”,接口负责 “做”,模拟执行和白名单负责 “把关”。
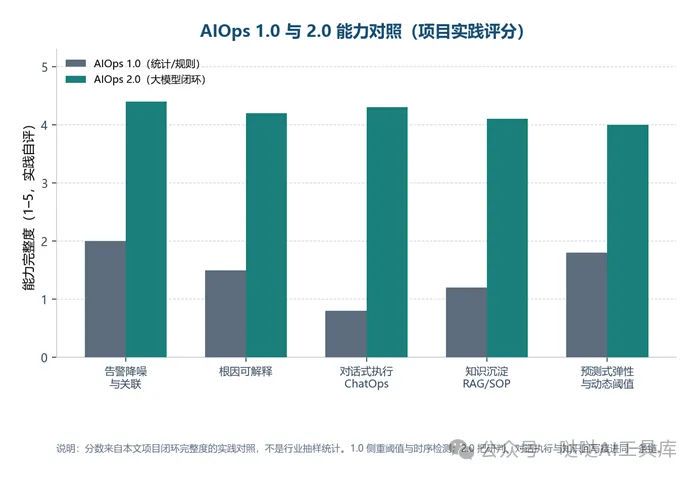
图 3:以前主要是发现异常;现在要把分析、执行、知识沉淀串起来(根据项目自评)
案例 1:把一堆告警收成几条故障故事
技术栈:DeepSeek+Prometheus+Alertmanager
一个底层故障,监控往往会连锁打出很多条告警。需要工作台先从 Alertmanager 把告警拉下来,去掉重复的,再让大模型做关联:
哪些是源头,哪些是连带的。要求它按固定格式输出,不要写成 “散文”。要写清时间、影响了哪些服务、根因告警是哪条、建议做什么、能不能自动执行。
我们有一次演练,86 条原始告警,降噪和关联之后变成 2 条故障说明、1 个需要人确认的修复动作。
AI给出方案后,先模拟执行,不会直接改生产;人确认了才真正修复。修复完,还能导出 Word,方便复盘。
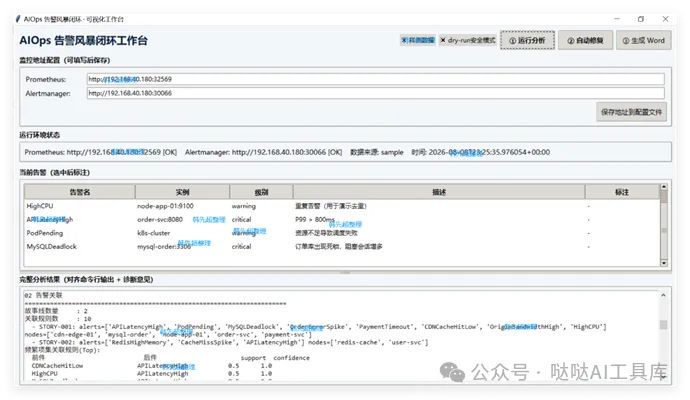
图 4:告警风暴处理工作台:接上 Prometheus 和 Alertmanager,可以先模拟再修复
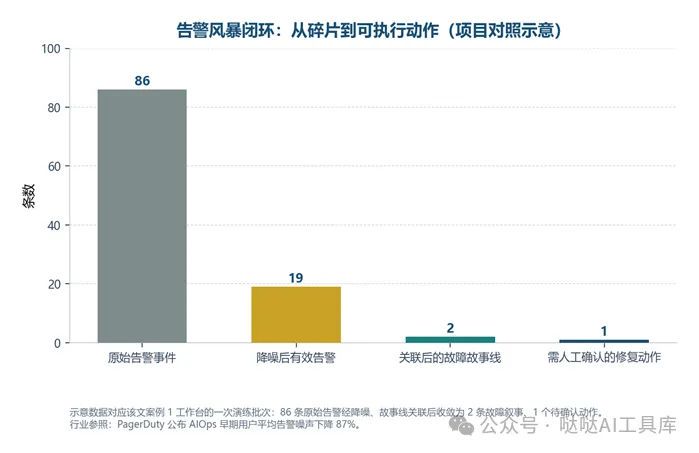
图 5:一次演练里告警是怎么一层层变少的(示意)
关键代码并不复杂:先把告警收成 JSON,再规定模型必须按这个结构回答。
代码 1:从 Alertmanager 拉告警,并规定大模型怎么回答
import json, requests
from datetime import datetime, timezone


AM = "http://192.168.40.180:30066"


def fetch_alerts():
  r =   requests.get(f"{AM}/api/v2/alerts", timeout=8)
  r.raise_for_status()
 rows = []
 for a in   r.json():
     rows.append({
       "name": a["labels"].get("alertname"),
       "inst": a["labels"].get("instance"),
       "sev": a["labels"].get("severity"),
       "desc":   a["annotations"].get("description", ""),
       "starts": a.get("startsAt"),
     })
  return rows


def build_prompt(alerts):
  return (
     "你是值班助手。只根据下面的告警做关联,不要编造没有出现的服务。\n"
     "请输出   JSON,字段包括:root_alert(根因)、derived(连带告警)、"
     "action(建议动作)、auto_allowed(能否自动执行,默认 false)。\n"
     f"当前时间:   {datetime.now(timezone.utc).isoformat()}\n"
     f"告警列表:   {json.dumps(alerts, ensure_ascii=False)}"
  )
案例 2:用说话的方式做运维,夜里也能在手机上处理
纯敲命令对很多人并不友好,夜里出问题还得开电脑。我做了两套对话运维:一套是网页,一套是微信。
网页这套用 MCP 协议把 Jenkins 的能力收成几个固定工具,比如 “列出任务”“触发构建”。
人用中文说一句,模型只能调用这些工具,不能自己去拼 Jenkins 的网址。查状态可以很快返回;真要构建,必须再确认一次。
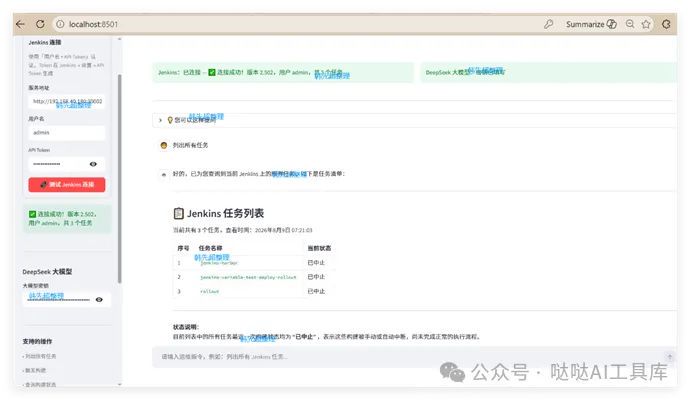
图 6:对话运维台:用自然语言列出 Jenkins 任务,并解释当前为什么是 “已中止”
微信这套把同样的能力接到聊天窗口。手机发一句 “看看构建日志” 或 “重新跑一下这条流水线”,就能拿到结果,也能看出卡在人工审批的节点。
夜里不用再抱着笔记本连 VPN。聊天记录本身就是操作日志,方便事后核对。
代码 2:把 Jenkins 操作收成带确认开关的工具,查询和变更分开
# 模型只能调用下面这些工具,不能自己发明接口
tools = [
  {
      "name": "jenkins_list_jobs",
      "description": "列出 Jenkins 任务和当前构建状态",
      "input_schema": {"type": "object",   "properties": {}}
  },
  {
      "name": "jenkins_build",
      "description": "触发一次构建。生产任务必须确认后才能真正执行",
      "input_schema": {
         "type": "object",
         "required": ["job", "confirm"],
         "properties": {
            "job": {"type": "string"},
            "confirm": {"type": "boolean"},
             "dry_run": {"type": "boolean",   "default": True}
      }
   }
 }
]


def jenkins_build(job, confirm, dry_run=True):
  if dry_run   or not confirm:
     return   {"accepted": False, "preview": f"将构建 {job},等待确认"}
     return   client.build_job(job)
案例 3:老监控 Zabbix 也能接上大模型
很多企业还在用 Zabbix,不可能为了 AI 把监控推倒重来。
我用 Python 做了个内网桌面工具,通过 Zabbix 接口拉取最近一天、七天、一个月的数据和告警,找出 CPU、内存占用高的进程,交给 DeepSeek 写根因和修复建议。
自动重启只对白名单生效,比如 Nginx、业务 Java。sshd、systemd 这类系统进程一律不许动。工具跑在内网,监控数据不会传到外面。
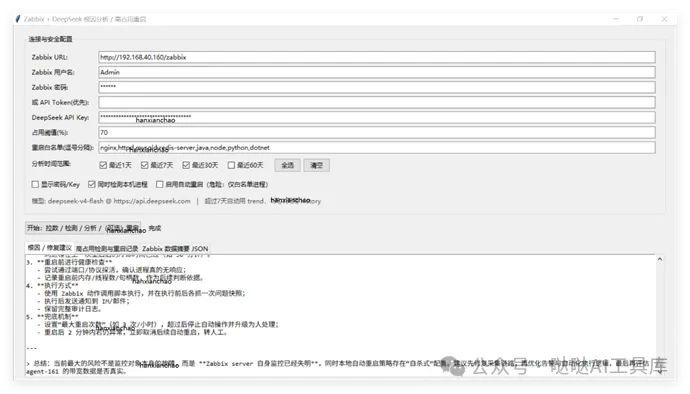
图 7:内网桌面工具:从 Zabbix 拉数据,大模型出报告,重启受白名单限制
静态阈值还有一个老问题:白天业务高峰容易漏报,夜里负载很低又容易误报。
我用脚本定期看机器 CPU 的实际水平,算出一个动态阈值,再通过 Zabbix 接口改触发器。
同时设一个最低门槛,比如不低于 45%,避免夜里被一点点抖动打穿。内存、磁盘、网络也可以用同一套办法。
代码 3:用 Zabbix 接口改告警阈值,并用黑白名单限制自动重启
import requests


ZBX =   "http://192.168.40.160/zabbix/api_jsonrpc.php"
TOKEN = "********"
SAFE_RESTART = {"nginx", "java",   "python", "dotnet"}   # 允许自动重启
HARD_DENY = {"sshd", "systemd",   "dockerd", "kubelet"}   # 绝对不能动


def zbx(method, params):
  payload =   {"jsonrpc": "2.0", "method": method,   "params": params, "id": 1, "auth": TOKEN}
  return   requests.post(ZBX, jsnotallow=payload, timeout=12).json()["result"]


def patch_cpu_trigger(p95_cpu, floor=45):
  # 动态阈值:业务分位往上留一点余量,同时不低于兜底值
  threshold =   max(int(p95_cpu + 8), floor)
   expr =   f"last(/{{HOST:cpu.util}})>={threshold}"
   return   zbx("trigger.update", {"triggerid": "12045",   "expression": expr})


def may_restart(proc_name: str) -> bool:
  name =   proc_name.lower()
  if any(d in   name for d in HARD_DENY):
     return   False
  return   any(s in name for s in SAFE_RESTART)
案例 4:Prometheus 动态告警,以及提前扩容
Prometheus 这边,静态 80% 一样不好用。
我用 Python 拉历史曲线,用 Prophet 学习白天高峰、夜里低谷的规律,生成两套阈值,再改 rules.yml 让规则生效。
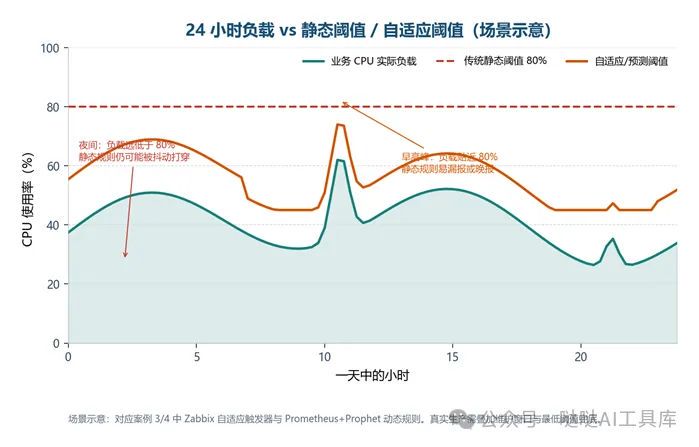
图 8:一天里的 CPU:固定 80% 和跟着业务走的阈值,差在哪(示意)
弹性伸缩是另一个痛点。原生 HPA 看到 CPU 高了才开始加副本,新 Pod 还要启动一段时间,流量高峰时很容易 503。
我们的做法是:持续采集 CPU、内存、QPS、延迟,让大模型估计未来 10 分钟、30 分钟、60 分钟大概要多少副本,赶在流量上来之前先加好。
预测结果不会直接覆盖人工定的上下限。节假日、发版、演练的时候,模型只给建议,不当真控制器。还要做防抖,不然预测一晃,集群就会来回扩缩。
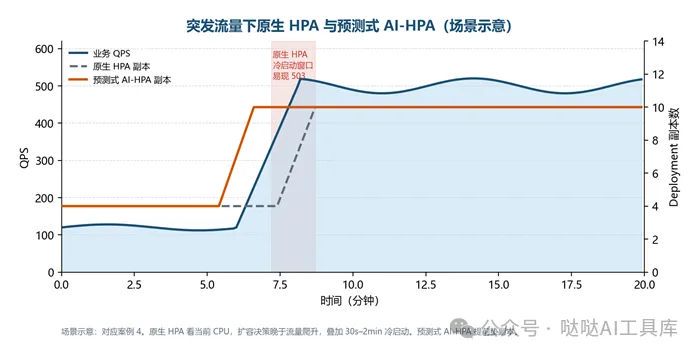
图 9:流量突然上来时:等 CPU 升高再扩容,和提前加好副本,结果差很多(示意)
代码 4:用 Prophet 算动态阈值;扩容默认先模拟,确认后再改副本数
from prophet import Prophet
import pandas as pd
from kubernetes import client, config


def fit_threshold(ts: pd.DataFrame) ->   pd.DataFrame:
  m =   Prophet(daily_seasnotallow=True, weekly_seasnotallow=True)
    m.fit(ts.rename(columns={"t": "ds",   "cpu": "y"}))
  future =   m.make_future_dataframe(periods=96, freq="15min")
  fcst =   m.predict(future)
   fcst["thr"] = (fcst["yhat"] + 12).clip(lower=45,   upper=92)
  return   fcst[["ds", "yhat", "thr"]]


def recommend_replicas(pred_qps, qps_per_pod=80,   lo=3, hi=20):
  want =   int(pred_qps / qps_per_pod) + 2 #多留 2 个,给冷启动留时间
  return   max(lo, min(hi, want))


def apply_scale(ns, name, replicas, dry_run=True):
  config.load_kube_config()
  apps =   client.AppsV1Api()
  body =   {"spec": {"replicas": replicas}}
  if dry_run:
     return   apps.patch_namespaced_deployment(name, ns, body, dry_run="All")
     return   apps.patch_namespaced_deployment(name, ns, body)
案例 5:从海量日志里找出隐患,再用自己的知识库来回答
有些问题监控还没告警,日志里已经出现了,比如权限不足、要伸缩的 Deployment 其实不存在。人工在日志里捞,效率很低。
这个平台对接 Elasticsearch,用历史日志先画出 “正常长什么样”,再找出明显偏离的片段,交给大模型判断风险等级、影响范围、根因和应急步骤,报告可以导出 Word 或 PDF。
经验:统计和基线负责把可疑日志找出来,大模型只解释这些片段。让模型直接读几百万行,又贵又慢,还容易被同一段报错刷屏带偏。
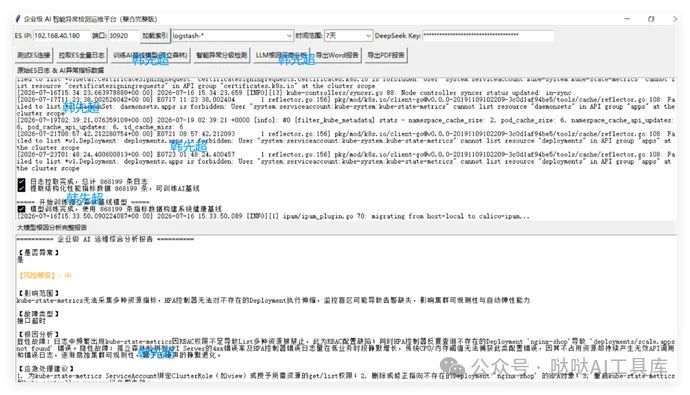
图 10:日志异常检测:找出 kube-state-metrics 权限不够,HPA 其实已经看不全集群
通用大模型还有幻觉问题,给的排障步骤经常和公司环境不一致。我们把故障手册、SOP、真实案例做成向量库。
遇到问题,先检索内部文档,再让模型整理成能复制执行的命令。如果知识库里没有对应内容,必须写明 “知识库没覆盖到,以下只是推测”,不能装得很确定。
在这个基础上,还有一个一键诊断工具:自动采集 Pod 状态、容器日志、集群事件,结合内部规范,直接出一份诊断报告,少翻很多页面。
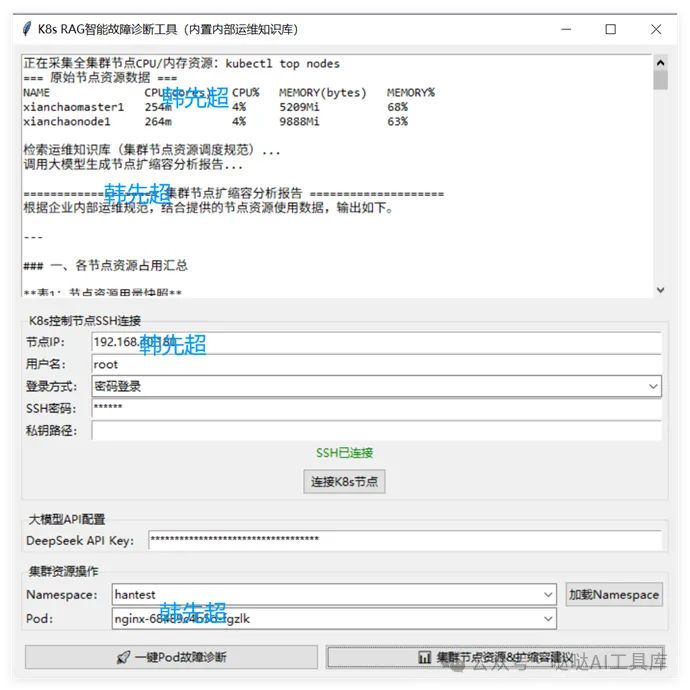
图 11:K8s 诊断工具:采集节点资源后,按公司内部规范给出扩容建议
代码 5:先用检索找出可疑日志和相关文档,再让大模型解释,并带上出处
from elasticsearch import Elasticsearch
from pathlib import Path


es =   Elasticsearch("http://192.168.40.180:30920")


def recall_anomalies(index="logstash-*",   minutes=60, size=50):
  q = {
     "query": {
       "bool": {
         "must": [{"range": {"@timestamp":   {"gte": f"now-{minutes}m"}}}],
         "should": [
            {"match": {"message": "forbidden"}},
            {"match": {"message":   "CrashLoopBackOff"}},
            {"match": {"message":   "ImagePullBackOff"}},
         ],
         "minimum_should_match": 1,
       }
     },
      "size": size
   }
   hits =   es.search(index=index, body=q)["hits"]["hits"]
   return   [h["_source"].get("message", "") for h in hits]


def rag_answer(query, store, llm):
  docs =   store.similarity_search(query, k=4)
  cites =   [Path(d.metadata["source"]).name for d in docs]
  prompt = (
     "只根据下面这些内部文档回答。每条建议后面写上文档名。"
     "如果文档盖不住这个问题,请明确写:知识库未覆盖。\n"
     f"文档:   {chr(10).join(d.page_content for d in docs)}\n"
     f"现场情况:   {query}"
  )
    return   {"answer": llm.chat(prompt), "citations": cites}
案例 6:用中文管理 K8s,也能快速做出运维小工具
kubectl 命令不好记。我用 Streamlit 做了个内网网页,输入中文,比如 “查看kube-system 命名空间的 Pod”,先转成固定格式的 JSON,再去调集群接口。
人不用背命令,但每一次操作在系统里都是一次说得清的 API 调用,方便审计。
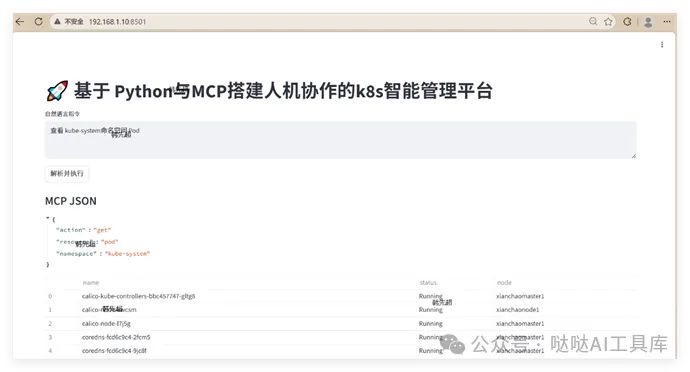
图 12:用中文查 Pod:先变成 JSON 指令,再列出 Running 的容器
另外还用 AI 辅助,很快搭了两个网页。一个是内网对话助手,可以说 “帮我给Nginx 加限流”,直接生成带注释的配置、Dockerfile、YAML 或脚本。
另一个是轻量的集群管理台,大约半小时做出能用的版本,网页上就能管理命名空间、工作负载和 Pod,不必完全依赖官方 Dashboard,数据也留在内网。
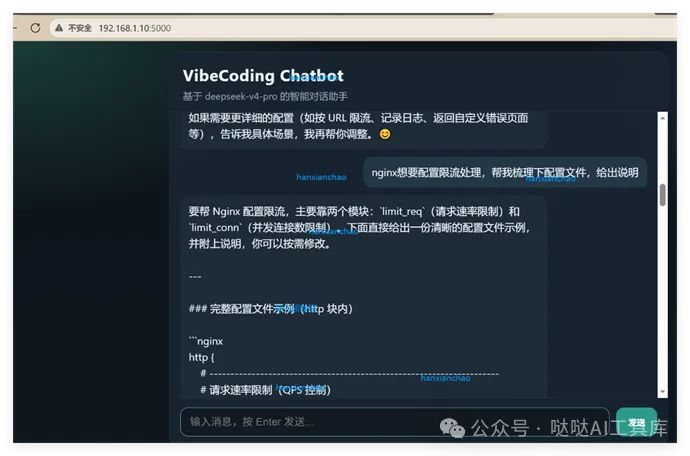
图 13:内网对话助手:用一句话生成 Nginx 限流配置,并附说明
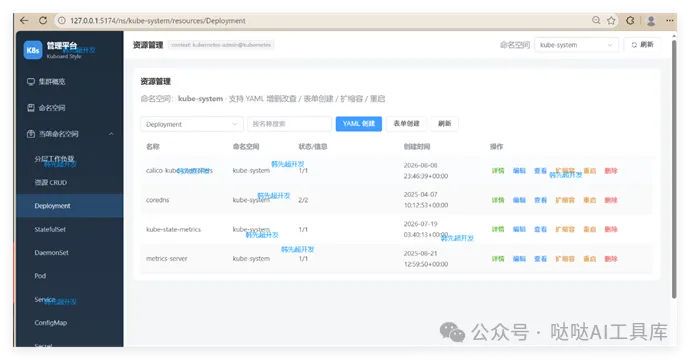
图 14:轻量 K8s 管理台:在网页上查看、扩容、重启、删除工作负载
代码 6:中文先转成白名单里的动作;改副本、删 Pod 默认先模拟
ALLOWED = {("get", "pod"),   ("get", "deploy"), ("scale",   "deploy")}
NEED_CONFIRM = {("scale",   "deploy"), ("delete", "pod")}


def parse_nl(text: str) -> dict:
    # 示例:把「查看   kube-system 的 Pod」转成结构化指令
    return   {"action": "get", "resource": "pod",   "namespace": "kube-system"}


def execute(cmd: dict, dry_run=True):
    key =   (cmd["action"], cmd["resource"])
    if key not   in ALLOWED:
        raise   PermissionError(f"不允许的操作: {key}")
    if key in   NEED_CONFIRM and dry_run:
        return   {"ok": True, "mode": "模拟执行", "cmd":   cmd}
    if   cmd["action"] == "get" and cmd["resource"] ==   "pod":
        return   v1.list_namespaced_pod(cmd["namespace"])
    raise   RuntimeError("尚未实现")
表 1:10 个项目一览
项目 | 解决什么问题 | 怎么做 | 安全上怎么卡 |
告警关联 | 告警太多,找不到根因 | 降噪+大模型整理 | 先模拟,再导出报告 |
网页对话运维 | 命令不好记 | 中文调用 Jenkins | 查询放开,变更要确认 |
微信运维 | 夜里必须开电脑 | 手机发一句话处理 | 聊天记录当审计 |
Zabbix 分析 | 老监控用不上 AI | 拉数据让模型写报告 | 进程黑白名单、内网部署 |
动态阈值 | 高峰漏报、低谷误报 | 按实际负载改触发器 | 设置最低阈值 |
Prometheus 预测 | 规则写死 80% | 按白天/夜里两套规则 | 发版窗口先冻结 |
预测扩容 | 来不及扩,出现 503 | 提前 10/30/60 分钟加副本 | 先模拟,再卡上下限 |
日志检测 | 问题藏在日志里 | 先找出异常,再让模型解释 | 输出标准报告 |
私有知识库 | 通用模型会胡说 | 先查公司文档再回答 | 查不到就明说 |
中文管集群 | kubectl 门槛高 | 中文转成固定 JSON | 只允许白名单操作 |
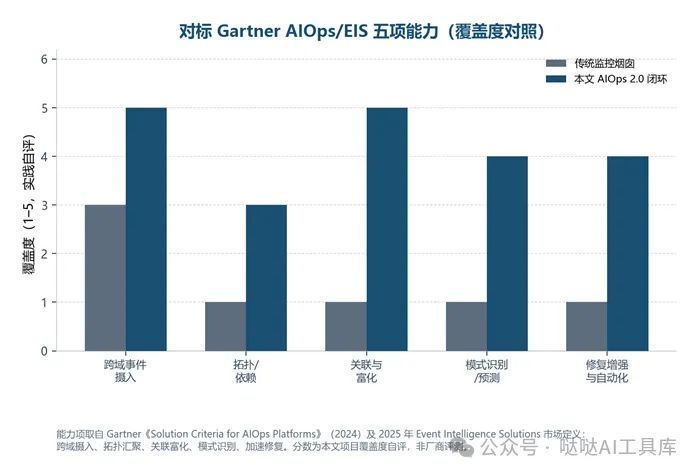
图 15:和传统监控相比,这套做法在关联分析和自动修复上更完整(自评)
落地时,踩过的坑
- 不要太相信大模型的输出。自动修复最怕误操作。我几乎每个项目都加了模拟执行、黑白名单和操作日志。方案先给人看,人点了再执行。
- 大模型适合读日志、做判断、写步骤,不适合自己去采集指标、调接口。采集和变更用普通程序来做,更稳。
- 能复用现成监控就复用。很多单位已经有 Zabbix 或 Prometheus,在上面接一层 AI,比换一套平台容易推动。
- 演示和生产差很远。演示可以全自动,生产还要考虑登录权限、内网隔离、超时重试、审计。我这些原型都优先保证数据留在内网。
- 知识库质量决定回答质量。文档又旧又乱,模型再强也写不出靠谱方案。
另外,Zabbix 的 history 和 trend 不要混用:短时间看明细,长时间看趋势,弄反了模型会以为 “一直很平稳”。
表 2:哪些能自动、哪些必须人来点,建议写进规范
级别 | 典型操作 | 能不能自动 | 至少要有什么 |
只读 | 查询、写报告、整理告警 | 可以自动 | 登录校验、脱敏、留日志 |
可改、可回退 | 加副本、重跑流水线、重启白名单进程 | 先模拟,人确认后再做 | 白名单、回滚办法、超时 |
风险大 | 删资源、改生产配置、关节点 | 默认不做,只给方案 | 两人确认、变更窗口 |
小结
以前做 AIOps,多半是用统计和固定规则找异常,看起来热闹,值班时往往用不上。
有了 DeepSeek 这类大模型,分析和写方案容易多了,但真正能用的关键还不在模型本身,而在后半段:建议出来之后,怎么安全地执行、怎么留下记录、怎么把经验写回知识库。
大模型不是来替代运维的。它是把人从刷告警、翻日志、反复写脚本里解放出来,把时间留给架构和难啃的故障。
上面这 10 个小项目都可以拿去改,接到自己环境里。监控继续用现在的,分析用大模型,改生产之前先模拟、再确认。这样做就比较踏实!