我是韩先超,51CTO 学堂 K8s、Python 教学总监、AIOps 实战训练营讲师,云计算架构师,具有 8 年项目实战经验+5 年教学经验,线上学员已达 300w+。
在云原生容器化、K8S(Kubernetes)业务运维里,弹性伸缩几乎是所有线上系统的标配。
很多团队直接使用 K8s 原生 HPA,上线初期看着很省心,但一遇到营销活动、突发流量,问题就会集中爆发。
原生 HPA 的痛点:永远慢流量一步
K8s 自带的HPA,判断扩缩容的逻辑很简单:只看当下实时 CPU、内存指标。
当一波突发流量瞬间打进来,指标飙升之后,HPA 才会感知到负载上涨,触发新建 Pod。而 Pod 从创建、拉取镜像、启动业务进程,到就绪承接流量,中间要经历 30 秒-2 分钟的冷启动窗口。
就在这段等待新 Pod 就绪的空档期,现有实例扛不住流量,接口报错、503 雪崩就来了。
流量是已经来了,伸缩动作才开始。这种被动响应模式,天然存在滞后性,是原生 HPA 最大的短板。负载回落时又容易出现抖动,频繁扩缩容也会给集群带来额外压力。
我们想要的理想伸缩能力,不是等流量来了再救火,而是提前预判流量变化,在峰值到来之前完成扩容,让业务从容扛住突发访问。
新思路:大语言模型赋能,打造预测式 AI-HPA
针对原生弹性伸缩的滞后问题,我们设计了一套结合 Prometheus 时序监控+DeepSeek 大模型的闭环 AI 弹性伸缩方案,把弹性伸缩从 “被动救火” 升级成 “主动预判”。
整套系统的核心思路,不再只盯着当前一瞬间的指标,而是让 AI 学习历史业务负载规律,提前输出未来一段时间的负载预估和副本调度建议。
完整工作链路拆解:
1. 监控数据持续采集
Prometheus 持续采集业务核心时序指标:CPU 使用率、内存占用、QPS、请求延迟 P95,把业务运行状态沉淀下来。
2. 指标汇总与 AI 请求封装
Python 服务定时拉取近一小时的历史监控数据,把时序指标整理成结构化提示词,提交给 DeepSeek 大模型做推理分析。
3. 多时段负载预测
大模型基于历史指标,一次性输出未来 10 分钟、30 分钟、1 小时三个时间窗口的负载等级,同时给出推荐 Pod 副本数量,并且附带决策理由,方便运维看懂 AI 判断逻辑。
就像操控台界面展示的一样,低负载场景下 AI 会建议维持最小副本数,节省集群资源。
4. 防抖策略+K8s 闭环执行
程序拿到 AI 给出的副本建议后,增加防抖逻辑,避免短时间反复扩缩容造成集群震荡。
确认策略稳定后,调用 Kubernetes API,直接修改 Deployment 副本数,完成自动扩缩容动作。
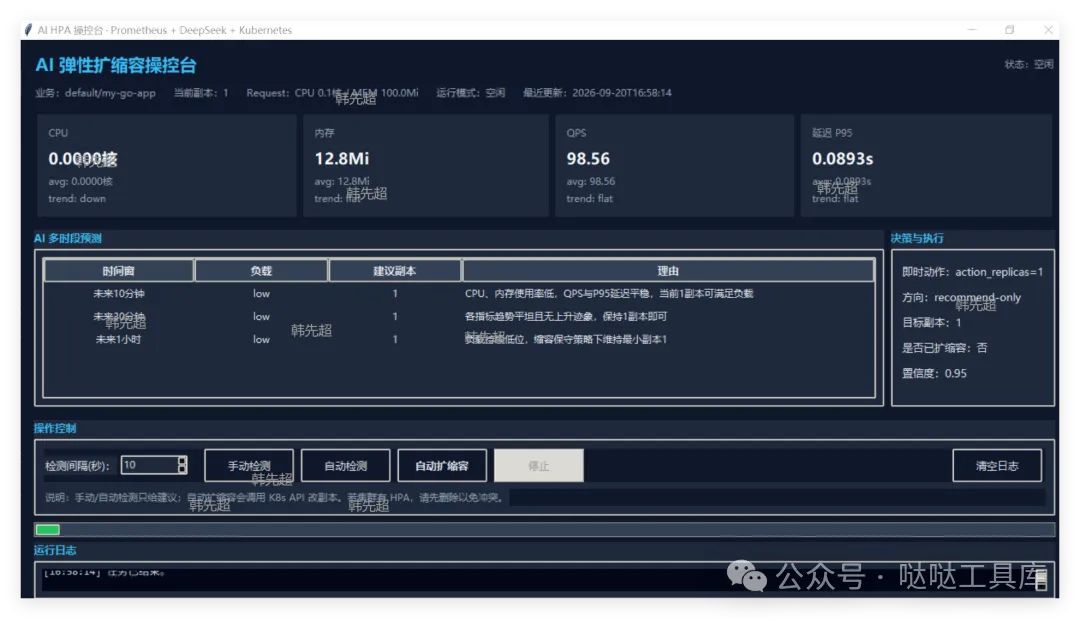
整个操控台界面可以直观看到实时资源指标、AI 多时段预测表格、扩缩容决策结果,同时支持手动检测、自动检测、自动扩容三种模式,还能查看完整运行日志,方便运维调试、排查问题。
落地价值
1. 消除 Pod 冷启动延迟带来的故障风险
流量峰值来临前提前扩容,杜绝突发流量下的 503 报错。
2. 资源精细化调度
低负载时段维持最小副本,不浪费集群算力。
3. 可解释的 AI 伸缩决策
每次扩缩容都附带理由,不是黑盒操作,运维更容易理解、审计。
4. 兼容现有 K8s 生态
复用 Prometheus 监控体系,不需要大规模改造现有业务,落地成本可控。
总结
传统弹性伸缩是 “看见问题再解决”,而 AI 预测式弹性伸缩是 “预判问题,提前布局”。
随着大模型和云原生运维不断结合,这类智能 AIOps 方案会越来越普及。把时序监控数据交给大模型做趋势推理,打通从预测到集群执行的完整闭环,正是云原生运维一个非常有价值的实践方向。
如果你也正在被流量突增、HPA 滞后抖动这类问题困扰,这套预测式 AI-HPA 思路,或许能给你的集群优化带来新参考。